研究成果 / 开放域关系抽取与强化学习

推理蒸馏与规则引导强化学习
驱动的开放域知识图谱构建

Reasoning Distillation and Rule-Guided Reinforcement Learning for Open-Domain Knowledge Graph Construction in Low-Resource Domains

开放域知识图谱 低资源文本 推理大模型 关系抽取 强化学习

论文信息

作者刘浏、杨帆、刘畅
机构南京农业大学信息管理学院
资助国家社会科学基金一般项目(No. 25BTQ026);江苏省社会科学基金一般项目(No. 24TQB004)

研究内容

法律文书、电子病历、古籍文献这类"低资源高歧义"语料缺乏大规模标注、语义歧义又高, 大模型处理时极易出现事实性错误。本研究以中文史籍为试验场,提出一套融合推理蒸馏、 细粒度规则与强化学习的开放域知识图谱自动构建框架。
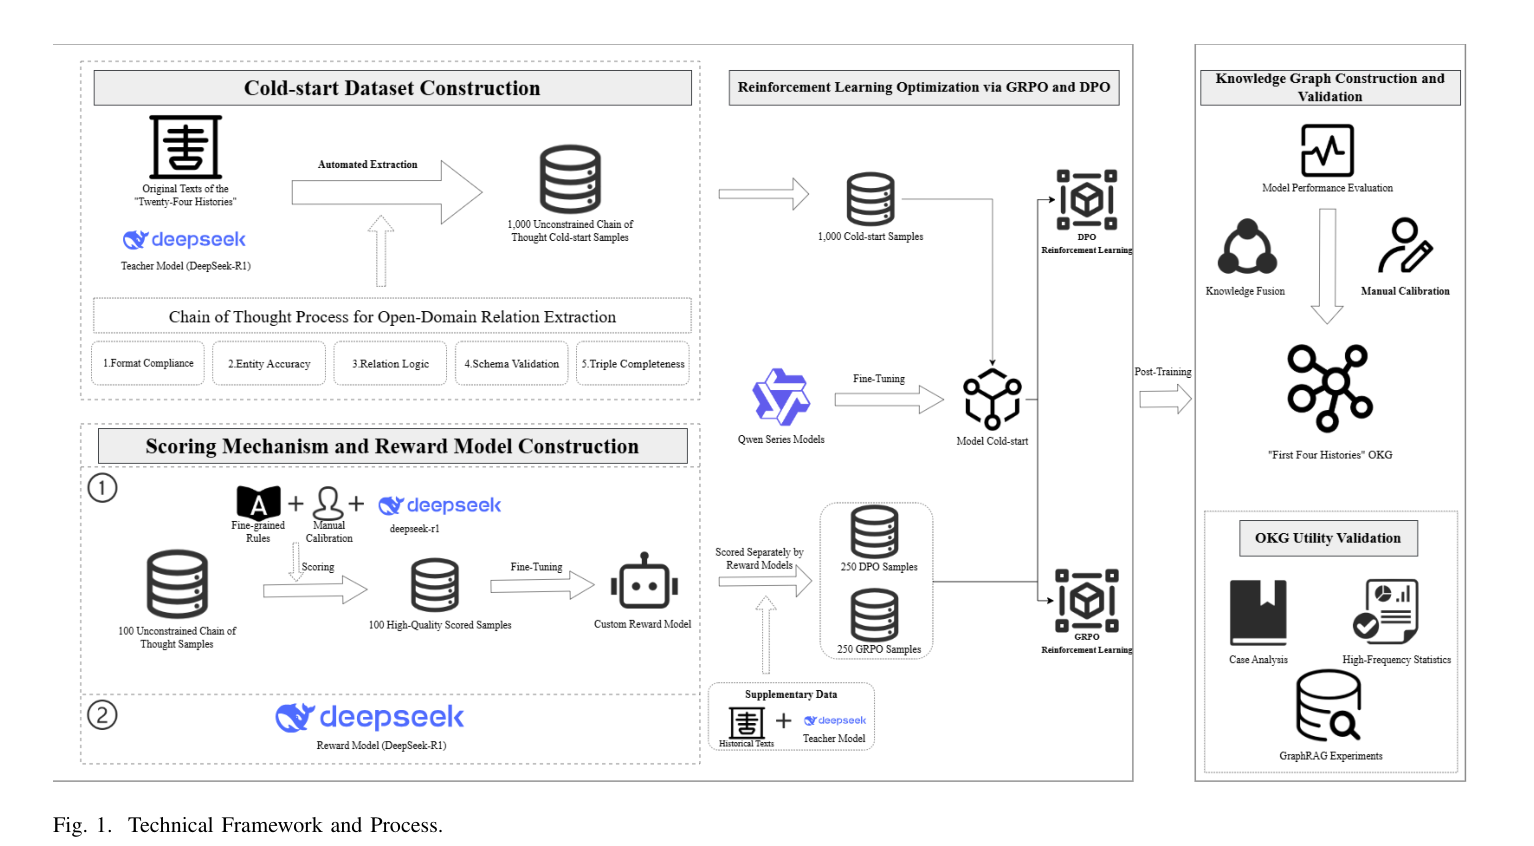
技术框架与流程
图 1 技术框架与流程

一、冷启动数据集构建

从二十四史中选取 1000 段语义密集的文本,以 DeepSeek-R1 作为教师模型, 用无约束的思维链提示生成推理轨迹,让模型自然产出推理步骤与 SPO 三元组, 形成冷启动训练集,绕开人工标注的高昂成本。
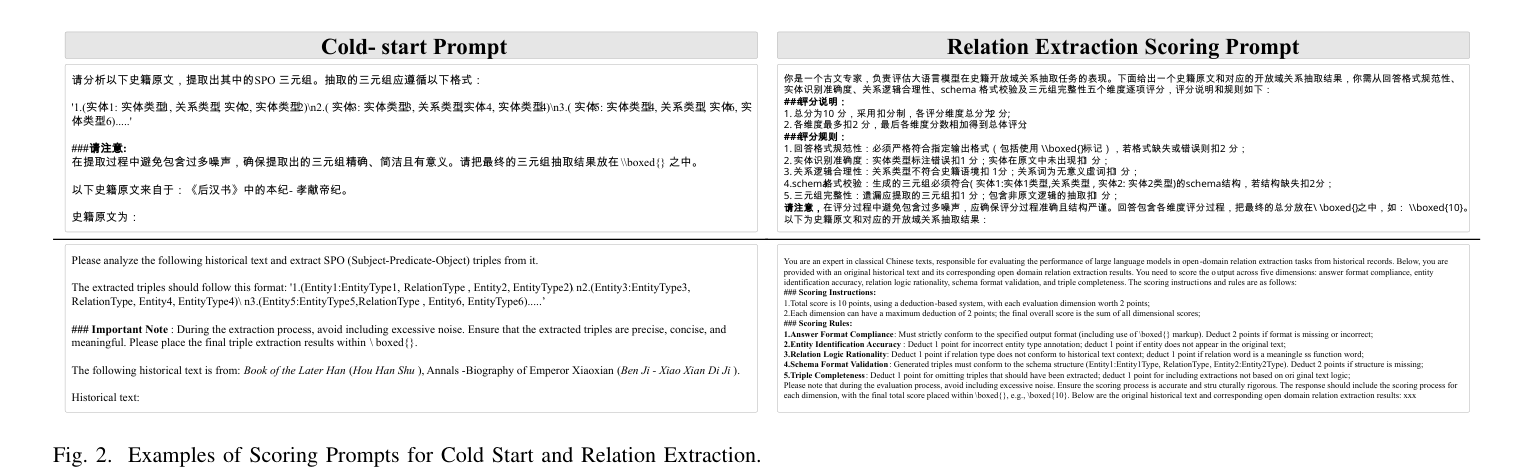
冷启动与关系抽取评分提示示例
图 2 冷启动提示与关系抽取评分提示示例

二、评分规则与奖励模型

设计五维度扣分制评分体系——回答格式规范性、实体识别准确度、关系逻辑合理性、 schema 格式校验、三元组完整性,每维 2 分、总分 10 分。 由 DeepSeek-R1 对 200 个样本打分并经人工校准(Kappa = 0.68),得到 250 条高质量评分数据集。 在此数据集上微调后,Qwen2.5-14B-Instruct 的评分准确率最高(82.9%),被选为自建奖励模型。

奖励模型候选的评分准确率
模型评分准确率
Qwen2.5-14B-Instruct82.9%
DeepSeek-R1-Distill-Qwen-14B77.2%
QwQ-32B63.3%

三、冷启动与强化学习优化

先用冷启动数据对五个模型做监督微调,再分别引入 GRPO 与 DPO 做对齐训练: GRPO 把自建奖励模型接入奖励函数并约束推理格式,DPO 则用评分 8–10 分的抽取结果作为正样本、 低分结果作为负样本构造偏好数据。训练使用 Swift 框架, 实验环境为 8×A800(CUDA 12.2),最大序列长度 4096,LoRA 微调。
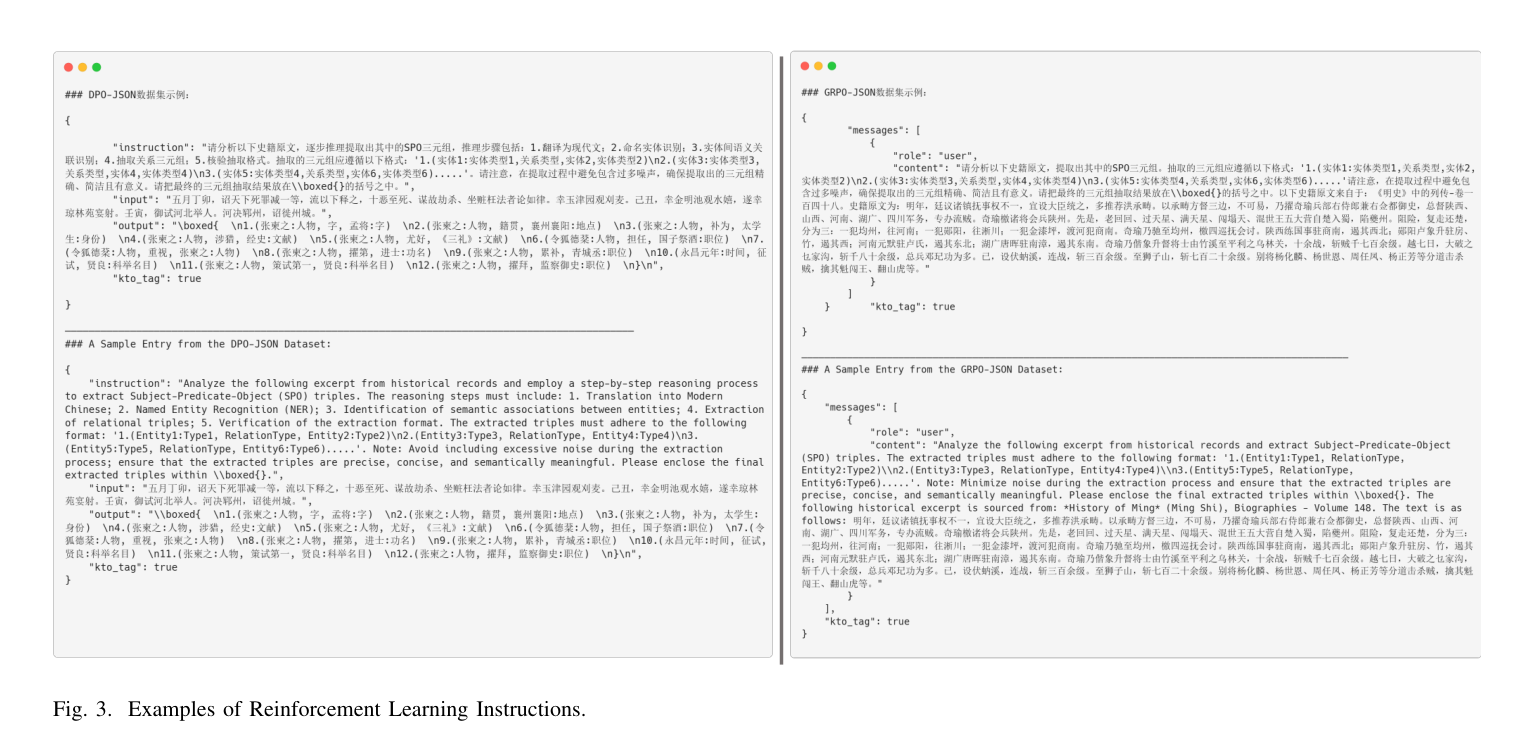
强化学习指令示例
图 3 强化学习指令数据示例

四、评测设计

在 cclue(天津大学)、CHisIEC(北京大学)、qiansishi 与 shiji(南京农业大学)四个测试集上评测, 每集随机抽取 200 条带参考答案的样本。除 F1、ROUGE-1/2/L、BLEU 外, 另定义 Score(单测试集四项指标均值)与 CWS(按各集实体关系类别占比加权的综合得分)。
实验结果

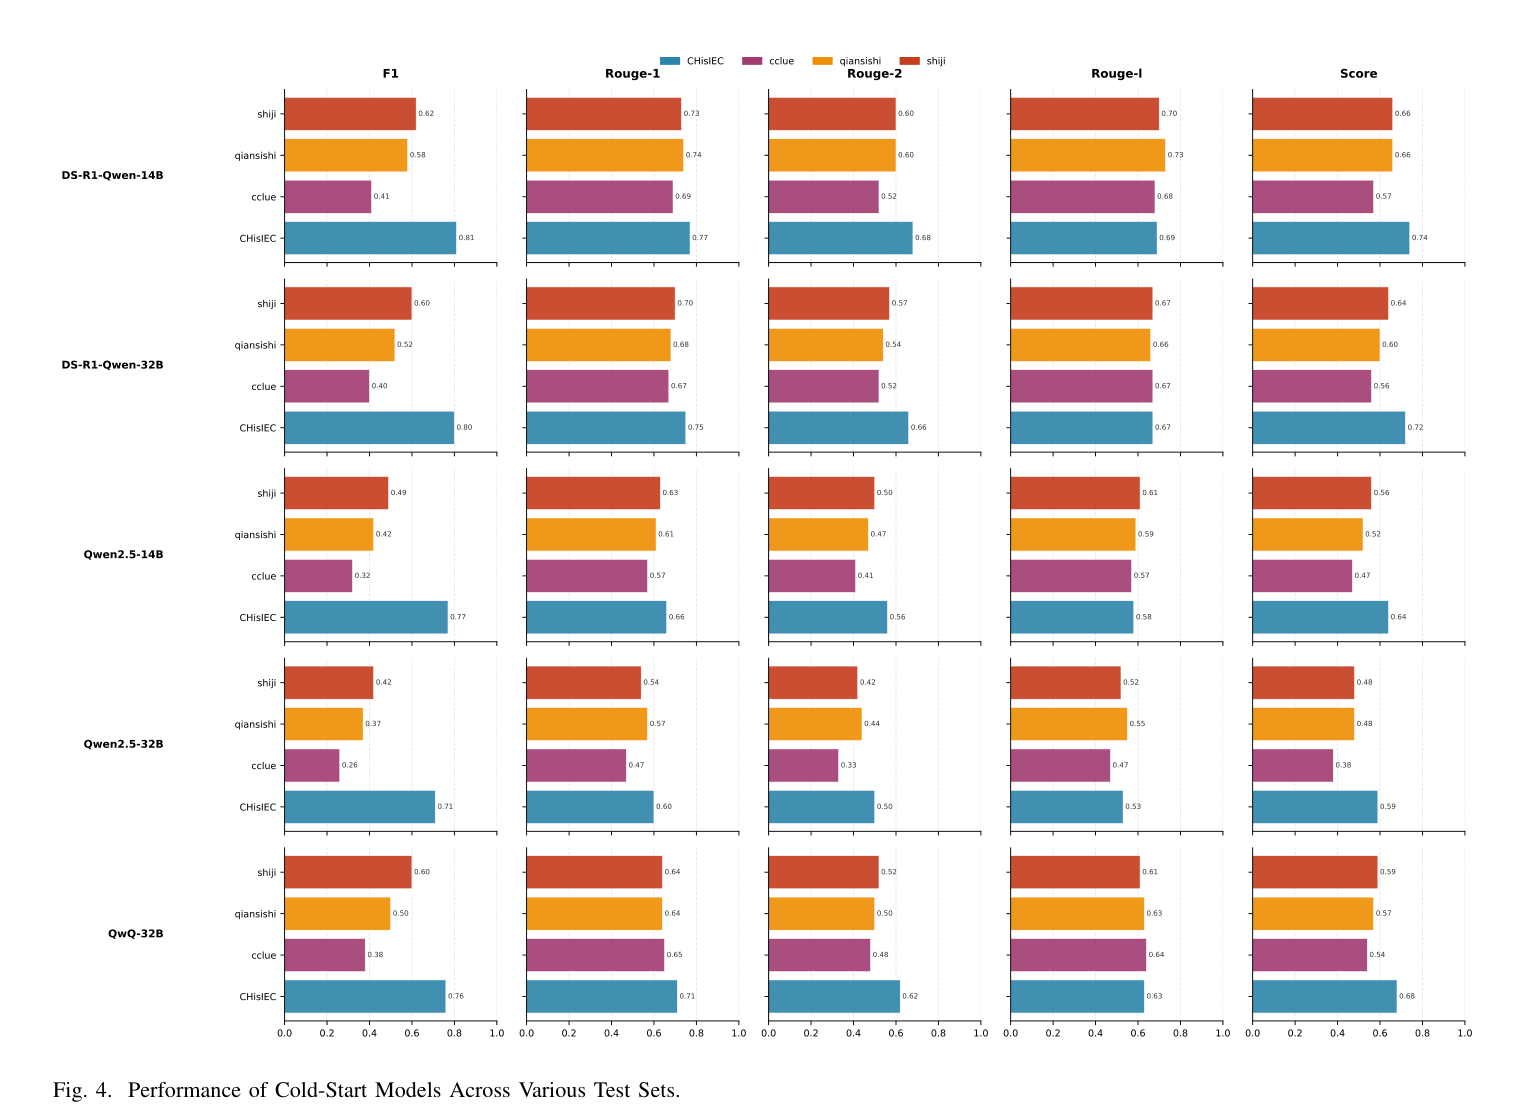
冷启动模型在各测试集上的表现
图 4 冷启动模型在各测试集上的表现
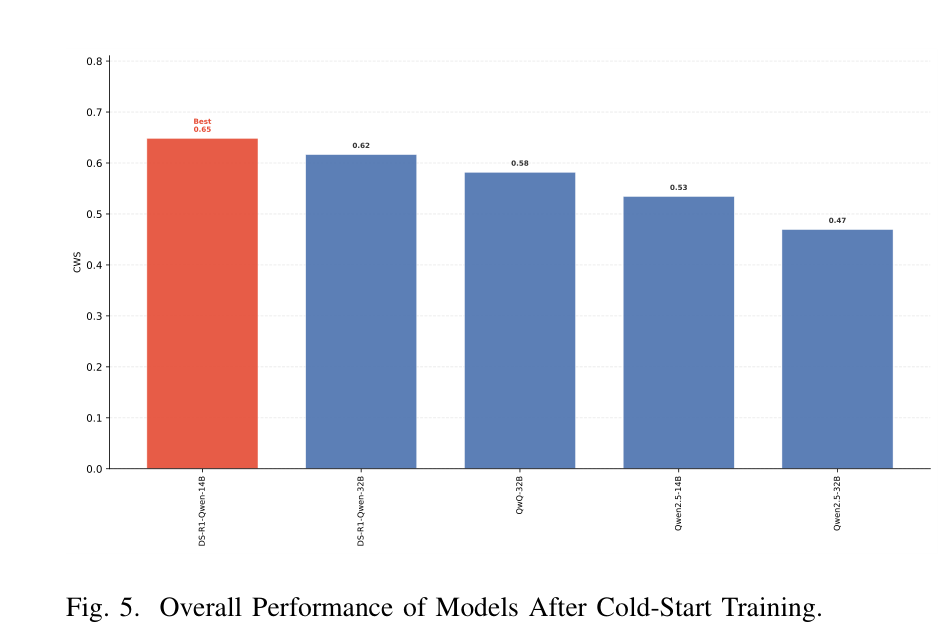
冷启动训练后模型整体表现
图 5 冷启动训练后模型的整体表现(CWS)

冷启动阶段出现一个反直觉现象:参数规模与性能并非严格正相关。 DeepSeek-R1-Distill-Qwen-14B 在关键指标上全面超过其 32B 版本, CWS 达 0.65(32B 为 0.62)。样本极度稀缺时,小参数模型收敛更快、领域适配效率更高。

DPO与GRPO强化学习后的整体表现
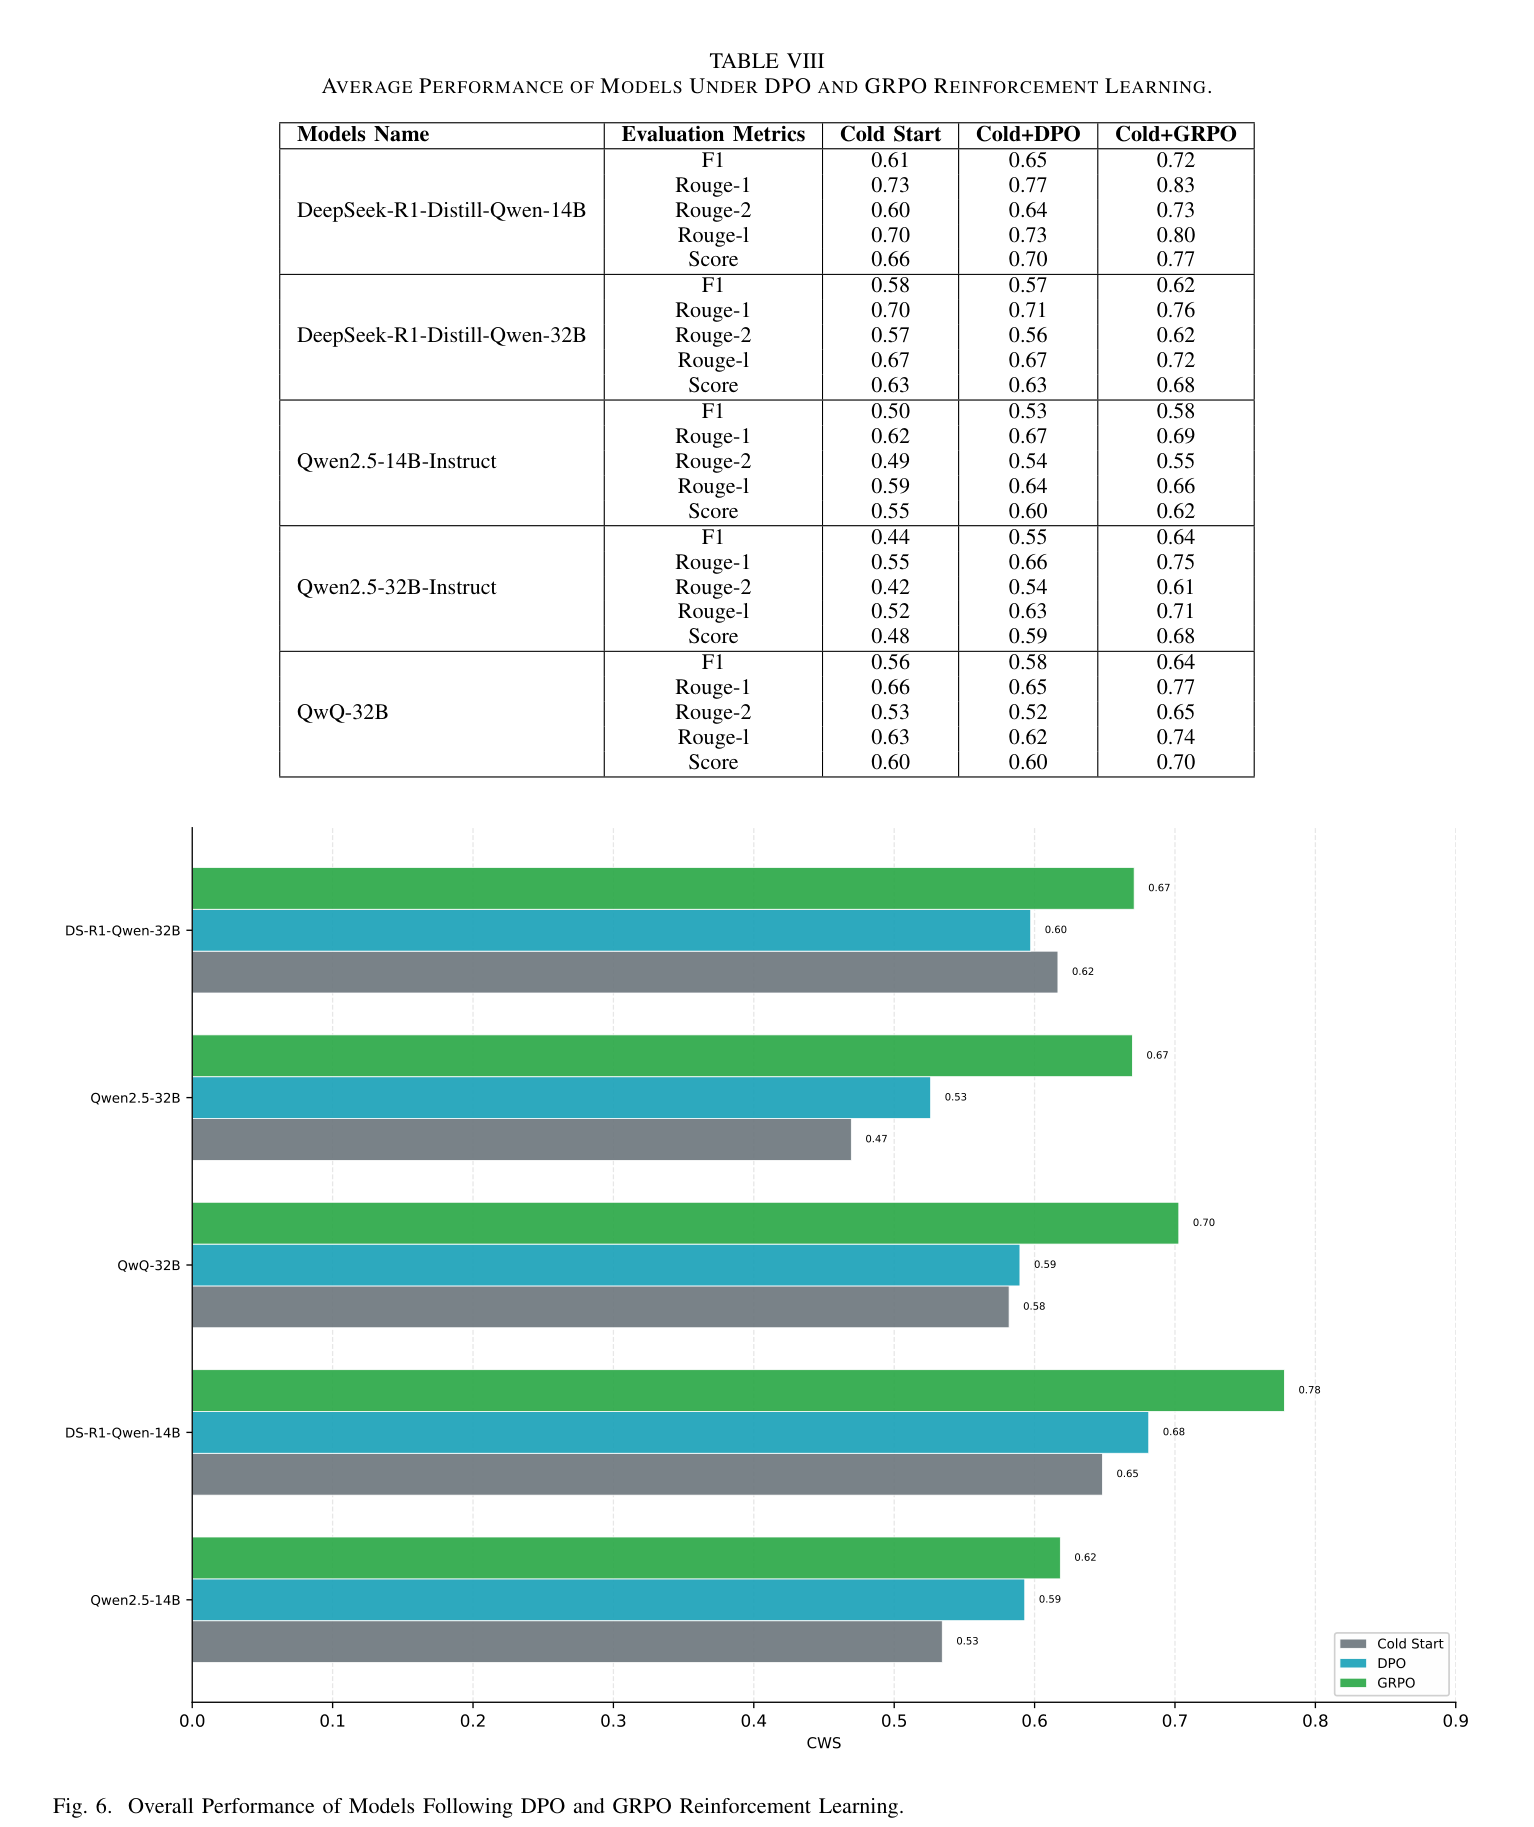
图 6 DPO 与 GRPO 强化学习后的模型整体表现
最优模型 DeepSeek-R1-Distill-Qwen-14B 各阶段表现
训练阶段F1ROUGE-1ROUGE-2ROUGE-LScoreCWS
冷启动0.610.730.600.700.660.65
冷启动 + DPO0.640.760.620.720.690.68
冷启动 + GRPO0.720.840.730.800.770.77

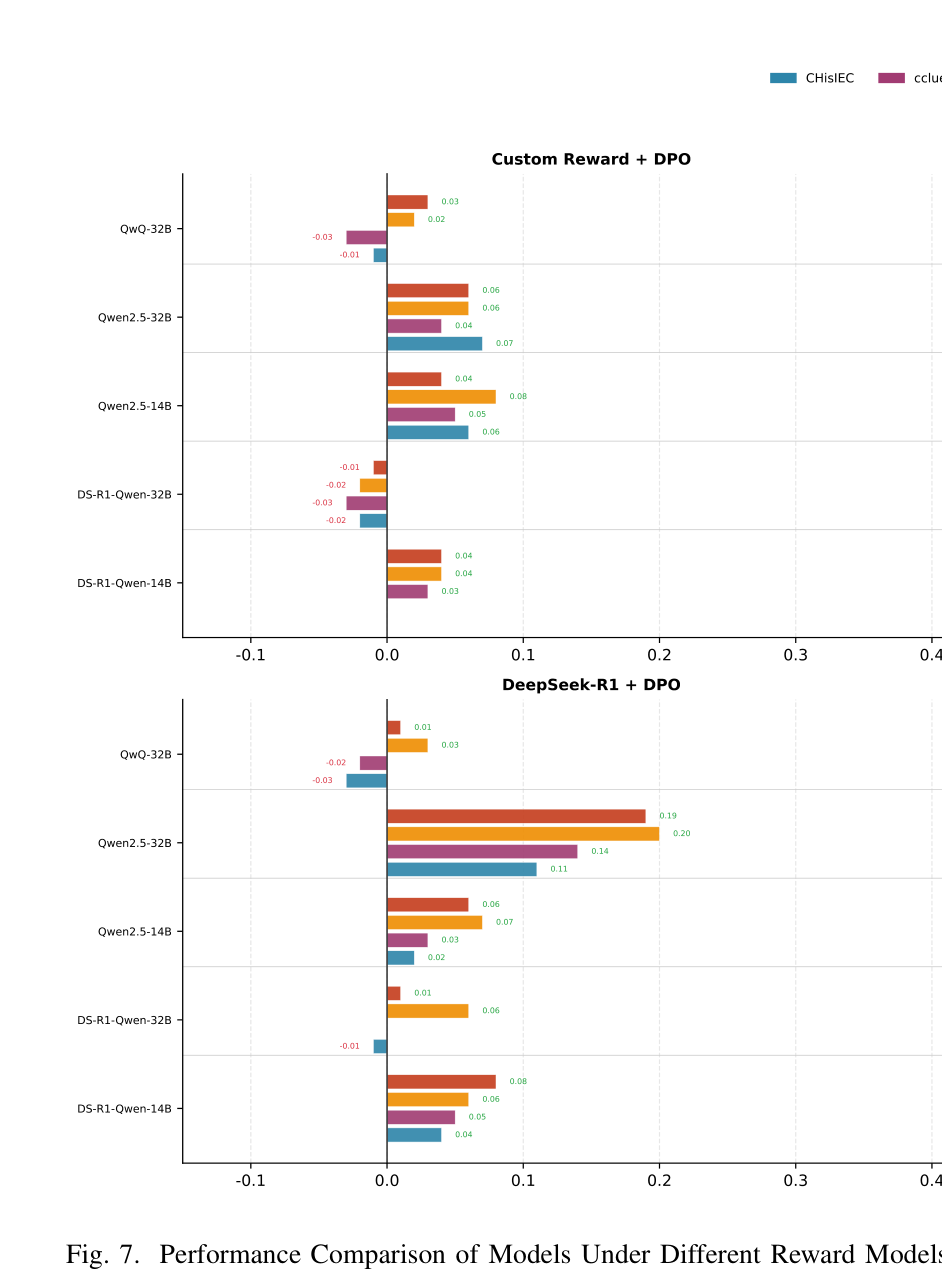
GRPO 的增益始终优于 DPO。史籍关系抽取是格式与逻辑约束都很强的任务, 基于规则扣分的 GRPO 比基于偏好排序的 DPO 更能约束生成空间。 DPO 对奖励信号质量高度敏感——换用自建奖励模型后部分模型出现性能倒退; GRPO 借助组内相对优势机制平滑了评分噪声,在低资源场景下更稳健。

不同奖励模型下的强化学习表现对比
图 7 不同奖励模型下 DPO / GRPO 相对冷启动基线的性能变化

更关键的结论是:自建奖励模型可以替代昂贵的教师模型 API。 对 DeepSeek-R1-Distill-Qwen-14B,自建奖励模型带来 0.31 的 CWS 增益, 略高于 DeepSeek-R1 API 的 0.30。

"前四史"开放域知识图谱

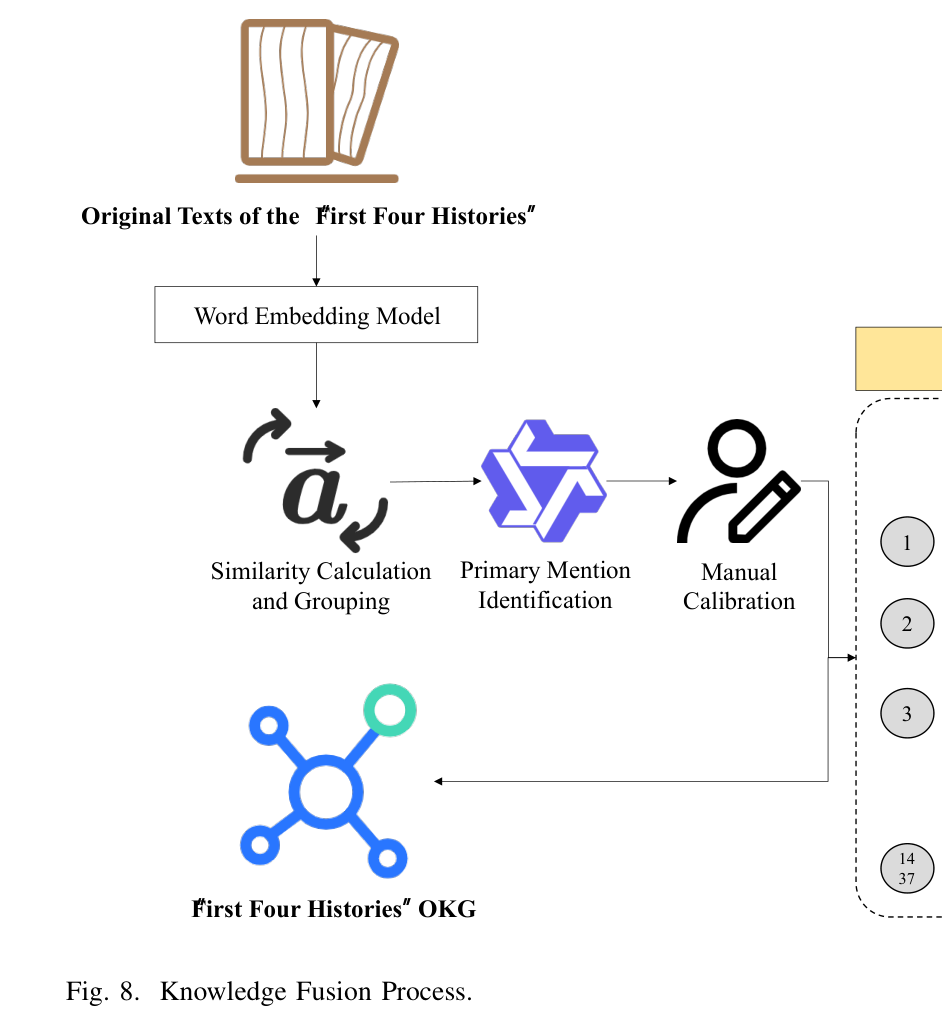
用最优配置(DeepSeek-R1-Distill-Qwen-14B + GRPO)对前四史全文做抽取, 再用词向量模型对实体与关系指称聚类、由大模型识别主指称并人工校准, 形成同义指称词典完成知识融合,最终入 Neo4j。

知识融合流程
图 8 知识融合流程
节点总数

42,681

边总数

63,253

实体类型数

8,427

关系类型数

15,992

八千余种实体类型、近一万六千种关系类型,正是开放域图谱与传统限定域图谱的根本差别: 模型不再受狭窄的预定义 schema 约束,得以捕捉史籍中长尾、细粒度、非标准化的语义关系。 实体类型中"人物"出现 47,966 次占绝对主导,其次为地点(10,179)与官职(7,198), 与纪传体史书"以人系事"的编纂体例高度吻合。

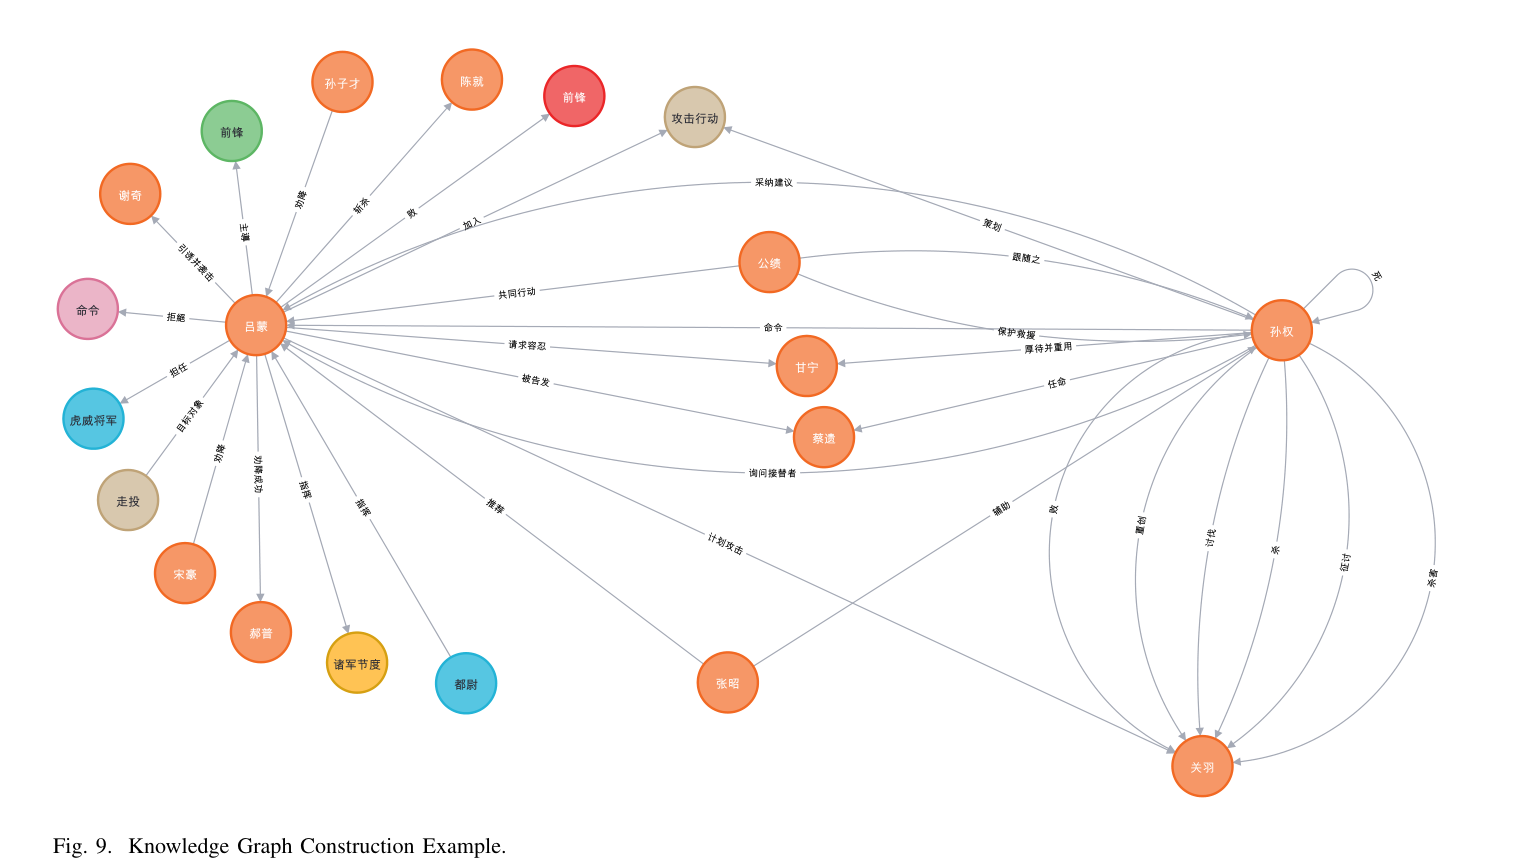
知识图谱构建示例
图 9 以吕蒙、孙权为中心的局部子图

图谱效用验证

把该图谱接入前期研发的 GraphRAG 对话系统,让模型回答 300 道中学历史题。 引入 GraphRAG 后,判断题 F1 由 0.65 升至 0.68,单选题 F1 由 0.93 升至 0.95, 其中单选题 0.95 的成绩超过了 671B 参数的 DeepSeek-R1。 简答题的 ROUGE/BLEU 基本持平甚至略降——图谱补充了参考答案之外的史料细节, 信息密度提高但与参考文本的字面重合度下降。

模型回答对比案例
图 10 基线模型与 GraphRAG 增强模型的回答对比

案例分析中,基线模型被问及"汉宣帝最宠爱的贵妃"时答成了汉章帝,属典型的长尾知识幻觉; GraphRAG 增强后不仅给出许平君这一正确结论,还同步呈现了各嫔妃的家族关系与宫廷事件时间线。

局限与展望

图谱在实体对齐与关系归一化上仍显粗放,后续将把实体链接与本体约束直接写入强化学习奖励函数, 从源头提升概念一致性;同时将构建更大规模基准数据集,引入 BERT 类小参数模型作对照组, 量化本框架在不同数据量下的边际收益与成本优势。